Khi AI Agent "Tự Tin Nói Dối": Câu chuyện về sự hỗn loạn Context và bài học tối ưu Token trong n8n
Trong các cộng đồng AI Automation gần đây, có một vấn đề khá nhức nhối mà nhiều người gặp phải: AI Agent báo "Đã cập nhật địa chỉ giao hàng cho khách" và kết thúc workflow với màu xanh mướt, nhưng thực tế trong Sheets không hề có thay đổi. AI tự tin khẳng định đã làm xong nhưng thực ra là nó đang "nói dối".
Hiện tượng này được gọi là Confident Hallucination (Ảo giác tự tin). AI không hề sai về ngôn ngữ, nhưng nó bị "lạc" trong chính đống dữ liệu khổng lồ mà chúng ta nạp vào.
Một trong những nguyên nhân phổ biến là Context Chaos (Hỗn loạn ngữ cảnh). Khi toàn bộ lịch sử chat, quy trình vận hành, chính sách giá và thông tin khách hàng được nhồi chung vào một prompt duy nhất, model dễ rơi vào trạng thái "Lost-in-the-Middle" — tức là nó quên mất những chỉ dẫn quan trọng ở giữa và bắt đầu tự "vẽ" ra kết quả để làm hài lòng người dùng.
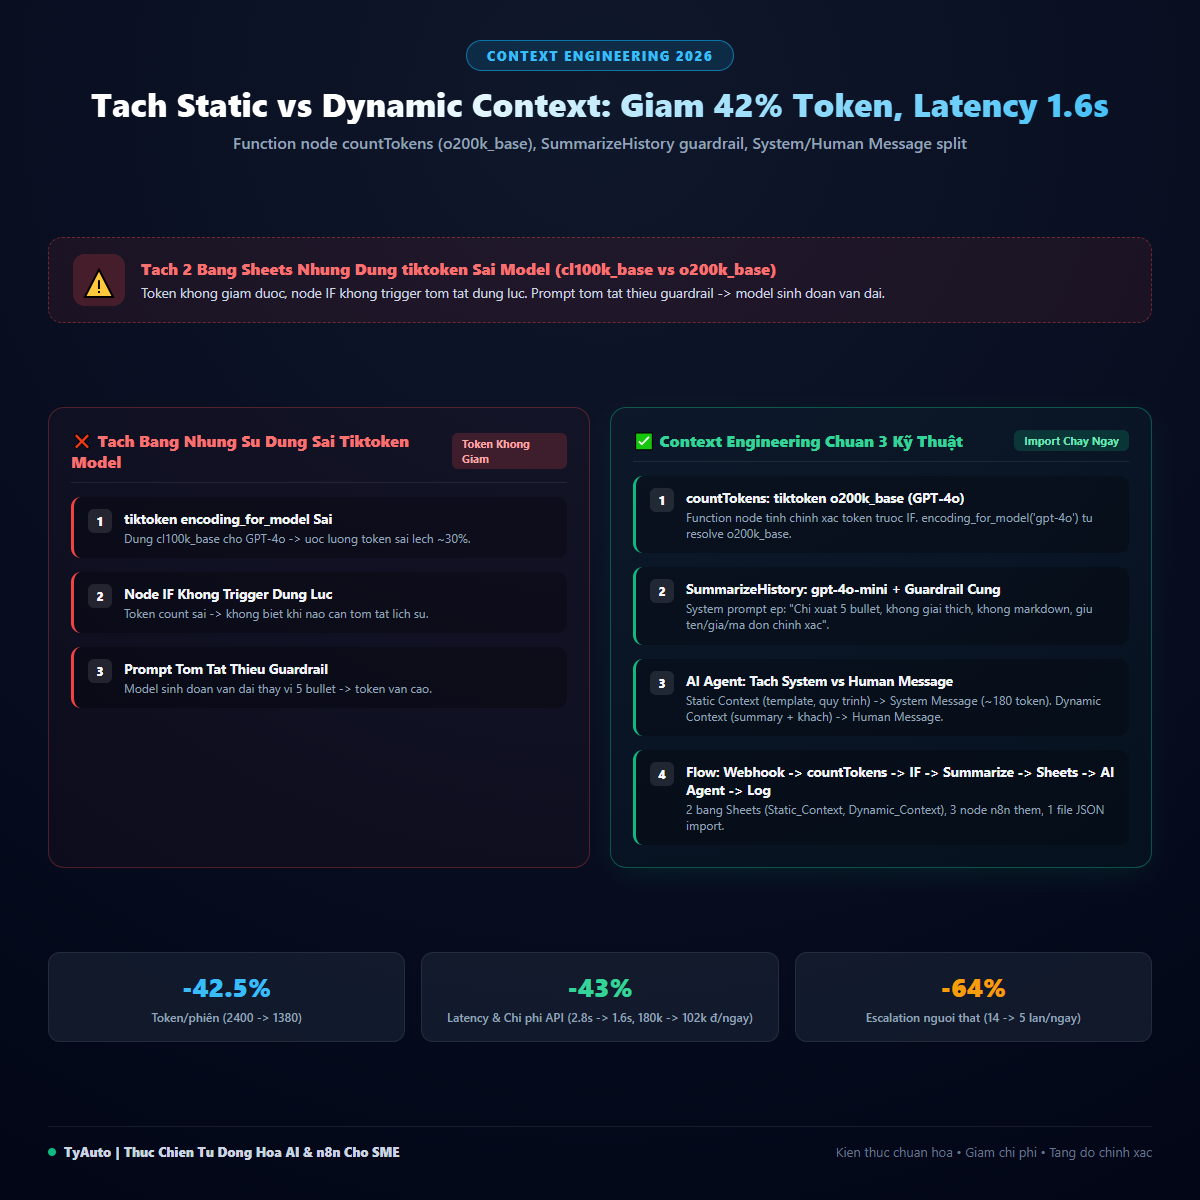
Ngoài ra, một lỗi kỹ thuật nhỏ nhưng gây hậu quả lớn là dùng sai model encoding khi tính token. Ví dụ, nếu dùng cl100k_base cho GPT-4o thay vì o200k_base, ước lượng token sẽ sai lệch ~30%, khiến node IF không trigger tóm tắt đúng lúc, làm context phình to và model bắt đầu "loạn".
Để xử lý vấn đề này, có 3 kỹ thuật tối ưu mà cộng đồng thường chia sẻ:
Chuẩn hóa "Thước đo" Token (o200k_base) Để tính token chính xác cho GPT-4o, cần dùng chuẩn o200k_base trong Function node trước khi đưa vào node IF check ngưỡng: const { encoding_for_model } = require('tiktoken'); const enc = encoding_for_model('gpt-4o'); const tokens = enc.encode($json.system_prompt + $json.dynamic_context + $json.user_message).length; return [{ json: { ...$json, token_count: tokens } }];
Kỹ thuật Selective Memory (Bộ nhớ chọn lọc) Thay vì tóm tắt mọi thứ, hướng tiếp cận hiệu quả là dùng một model rẻ hơn (như gpt-4o-mini) để "lọc tinh túy". Prompt được thiết kế để chỉ giữ lại: Tên sản phẩm, Mã đơn, Trạng thái cuối cùng và Yêu cầu chưa giải quyết. Việc xóa bỏ các nhiễu (noise) như lời chào, cảm ơn giúp AI tập trung hơn vào tác vụ chính.
Tách biệt Attention Window (System vs Human Message) Một kỹ thuật quan trọng khác là không nhét tất cả vào System Prompt:
- Static Context (Quy trình, Chính sách): Nạp qua System Message parameter. Đây được xem là "Luật" không thay đổi.
- Dynamic Context (Tóm tắt phiên chat, Info khách): Nạp qua Human Message parameter. Đây là "Biến số" thay đổi theo từng turn. Cách làm này giúp model phân định rõ ràng giữa "Luật" và "Dữ liệu", tránh hiện tượng bị nhầm lẫn.
Sơ đồ vận hành tham khảo: • Webhook → countTokens (o200k_base) → IF (>3000 token?) • Nếu True: summarizeHistory (gpt-4o-mini) → Update Dynamic_Context Sheets • Google Sheets: Read Static_Context (Luật) & Dynamic_Context (Biến số) • AI Agent (GPT-4o): Static vào System, Dynamic vào Human • Structured Output Parser → Log kết quả thực tế vào Sheets → Respond
Theo chia sẻ từ các case study thực tế, việc tối ưu này có thể mang lại kết quả đáng kể: • Độ tin cậy: Giảm thiểu tình trạng AI "nói dối" khi thực hiện tác vụ. • Hiệu suất: Latency P95 có thể giảm từ 2.8s xuống 1.6s. • Chi phí: Token trung bình/phiên giảm ~40%, giúp tối ưu ngân sách API hàng ngày.
Bài học rút ra cho anh em làm automation: Đừng quá tin vào "màu xanh" của node n8n. Một workflow chạy thành công không đồng nghĩa với việc kết quả trả về là đúng. Hãy kết hợp Token Count và bộ Evaluation Dataset để kiểm soát chất lượng.
Chi tiết schema 2 bảng Sheets, code Function node chuẩn và file workflow .json tham khảo mình để tại link Blog dưới phần bình luận nhé!
Anh em có bao giờ gặp trường hợp AI báo "Xong" nhưng thực tế "Chưa có gì" chưa? Cùng chia sẻ case của bạn để chúng ta cùng mổ xẻ nhé!
Bình luận
Giải pháp xử lý lỗi "AI nói dối", code Function node chuẩn o200k_base và file workflow .json tham khảo: https://tyauto.name.vn/posts/2026-09-22-personal-feed-context-engineering-static-dynamic.html
Hostinger VPS — n8n tự lưu trữ
Chạy n8n tự lưu trữ: workflow không giới hạn, số lệnh chạy đồng thời không giới hạn, dùng được node cộng đồng. Hoàn tiền trong 30 ngày. giảm tới 69%
Gigabyte RTX 5060 Ti Windforce MAX OC 16GB
Rẻ nhất trong nhóm 16GB VRAM. Đủ để tự host model local cỡ vừa và chạy n8n tại nhà mà không phải trả tiền API theo tháng. 14.309.000₫