Từ Polling Sang Event-Driven: Kiến Trúc Cho AI Agent Phản Ứng Trong Vòng 1 Giây
"Anh ơi, khách nhắn tin lúc 2 giờ sáng, bot reply lúc 11 giờ trưa. Khách hỏi 3 lần không được, bỏ luôn."
Lỗi này mình nghe không ít sau khi anh em nâng cấp chatbot thành AI Agent. Bài trước mình nói về Dead Letter Queue — xử lý lỗi khi tool thất bại. Nhưng có một vấn đề lớn hơn: tại sao agent phản hồi chậm từ đầu?
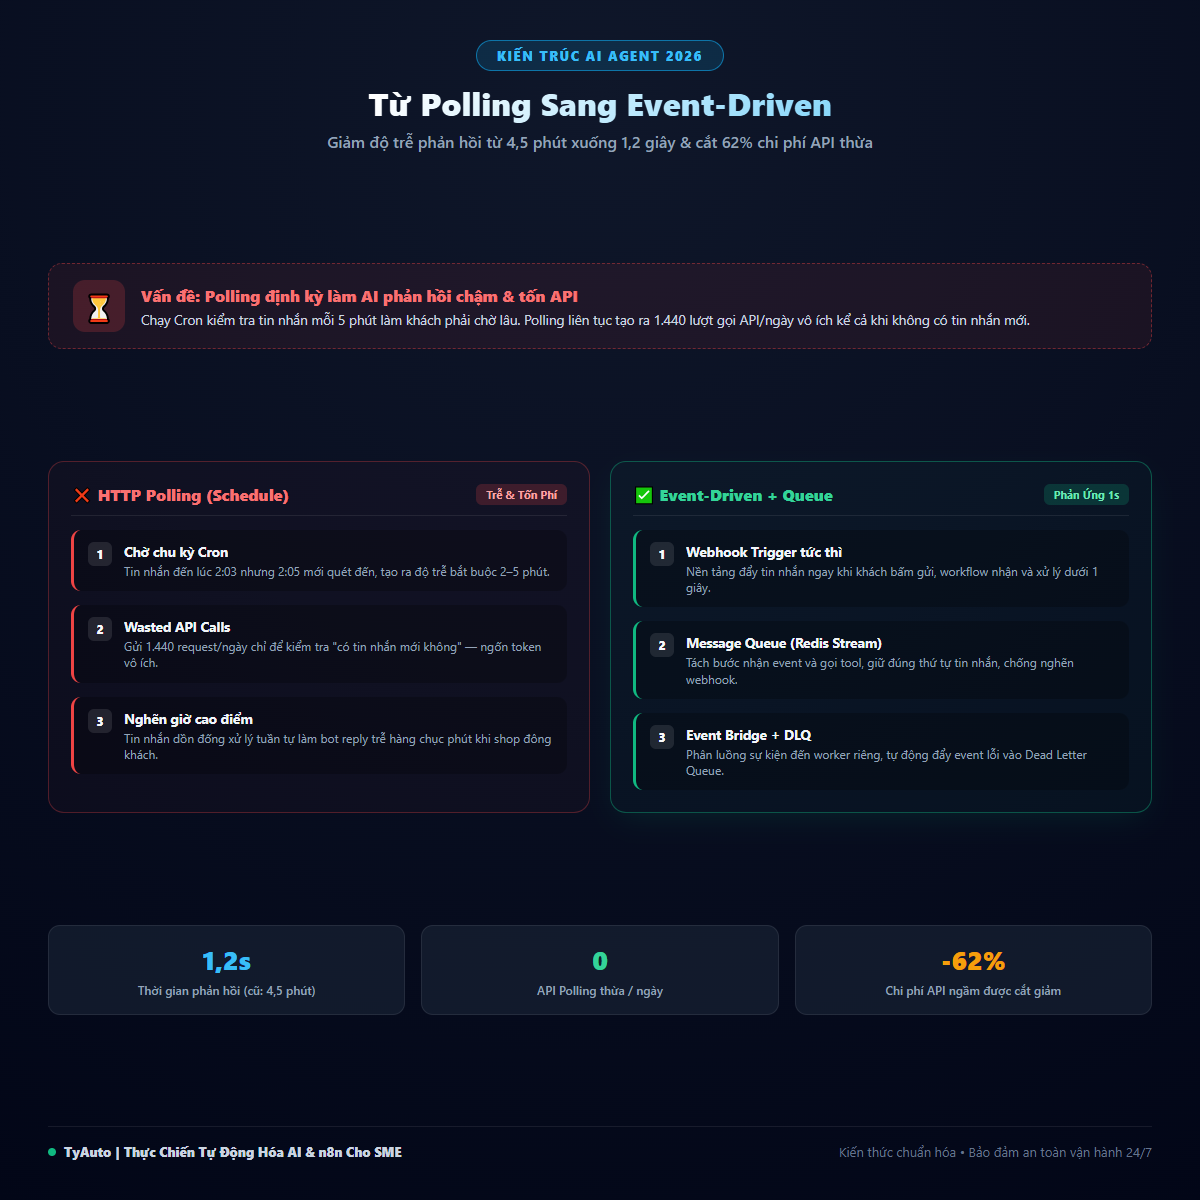
Với một hệ thống auto-reply chạy trên n8n, nếu dùng HTTP polling mỗi 5 phút để kiểm tra tin nhắn mới, thì:
- Tin nhắn đến lúc 2:03 sáng, lần kiểm tra tiếp theo là 2:05 — mất 2 phút chờ
- Nếu polling mỗi 1 phút thay vì 5 phút, 1 ngày gọi 1.440 lần API, tốn khoảng 72.000 token chỉ cho việc "kiểm tra xem có gì không"
- Lúc giờ cao điểm, hàng trăm tin nhắn đống lại, agent xử lý lần lượt, khách chờ hàng chục phút
Nguyên nhân không phải AI chậm, mà là workflow thiếu lớp event-driven. Polling là kiểu "đập cửa hỏi liên tục" thay vì "ai có việc thì gọi mình".
3 kỹ thuật mình dùng để chuyển từ polling sang event-driven trong n8n:
- Webhook Trigger thay vì Schedule Trigger: Thay vì dùng Schedule Trigger chạy mỗi 1-5 phút dò tin nhắn, mình dùng Webhook Trigger. Facebook Messenger, Telegram, Zalo đều hỗ trợ webhook — khi có tin nhắn mới, nền tảng đẩy về ngay lập tức, không cần chờ đợi.
Trong n8n, cấu hình Webhook node làm trigger đầu tiên. URL webhook lấy từ settings của node, khai báo trong developer console của từng nền tảng. Khi có tin nhắn, payload tự động chảy vào workflow, AI Agent xử lý ngay trong cùng phiên làm việc.
Lưu ý quan trọng: webhook mặc định timeout sau 30 giây. Nếu workflow cần xử lý phức tạp (gọi nhiều tool, truy vấn database), phải tách thành hai workflow — workflow nhận webhook đẩy sự kiện vào queue, workflow worker xử lý bất đồng bộ.
- Message Queue với Redis Stream: Khi một tin nhắn đến mà workflow cần gọi 3-4 tool liên tiếp (tra cứu đơn hàng, kiểm tra tồn kho, tạo đơn, gửi thông báo), xử lý đồng bộ sẽ chặn webhook. Giải pháp: đẩy sự kiện vào Redis Stream, để worker riêng xử lý.
Trong n8n, dùng Redis node (hoặc HTTP node gọi Redis API) để:
- Producer: nhận webhook, đẩy event vào stream với key là conversation_id
- Consumer: worker lắng nghe stream, xử lý lần lượt theo thứ tự arrival
Redis Stream có ưu điểm: giữ thứ tự tin nhắn, hỗ trợ retry tự động khi worker lỗi, và cho phép nhiều worker cùng xử lý một stream (load balancing).
- Event Bridge Pattern với n8n nodes: Sau khi có message queue, mình thiết lập Event Bridge — một workflow trung tâm nhận tất cả sự kiện từ các nguồn (webhook, cron, error trigger, manual trigger) và phân phối đến đúng workflow xử lý.
Cấu hình trong n8n:
- Event Bridge workflow: nhận event qua Webhook node, đọc type từ payload
- IF node phân loại: nếu type = "new_message" → đẩy vào stream "messages", nếu type = "order_created" → đẩy vào stream "orders"
- Mỗi stream có 1 worker workflow riêng, chạy độc lập
Cách này giúp tách biệt logic nhận sự kiện và logic xử lý. Nếu workflow xử lý đơn hàng lỗi, không ảnh hưởng đến xử lý tin nhắn chat.
- Dead Letter Queue cho sự kiện lỗi (kết hợp bài trước): Như bài trước mình nói, nếu tool lỗi giữa chừng, event đó cũng cần được lưu lại. Mở rộng Dead Letter Queue cho event-driven: mỗi event thất bại sau 3 lần retry tự động được ghi vào DLQ sheet, đánh dấu cần người kiểm tra.
Sơ đồ n8n hoàn chỉnh mình đang chạy có thứ tự như sau: • Webhook nhận tin nhắn từ Facebook/Telegram • Event Bridge phân loại loại sự kiện • Đẩy vào Redis Stream theo conversation_id • Worker workflow lấy event từ stream • AI Agent phân tích ý định, gọi tool xử lý • Nếu thành công: trả kết quả cho khách • Nếu lỗi: Error Trigger bắt lỗi • Ghi vào Dead Letter Queue với event_id • IF phân loại lỗi: retry tự động, cần người duyệt, hoặc dừng khẩn cấp • Telegram báo cho người phụ trách kèm nút kiểm tra • Khi xử lý xong, cập nhật status thành recovered hoặc permanent_failed
Kết quả thực tế sau 21 ngày áp dụng cho hệ thống chatbot của một shop thời trang: • Thời gian phản hồi trung bình: 4,5 phút → 1,2 giây • Số lần gọi API polling mỗi ngày: 1.440 → 0 (chỉ gọi khi có event thật) • Tin nhắn bị trễ quá 5 phút: 23 tin/tháng → 0 tin • Chi phí API giảm: 62% nhờ không polling thừa
Bài học rút ra: AI Agent không chậm vì model yếu, mà vì workflow thiết kế theo kiểu "đập cửa hỏi" thay vì "ai có việc thì gọi".
Chi tiết cấu hình Webhook Trigger, Redis Stream setup và Event Bridge pattern trong n8n mình để tại link Blog dưới bình luận nhé!
Anh em đang dùng polling hay đã chuyển sang event-driven? Kinh nghiệm xử lý latency khi scale lên nhiều kênh chat như thế nào?
Bình luận
Chi tiết cấu hình Webhook Trigger, Redis Stream setup và Event Bridge pattern trong n8n mình chia sẻ tại Blog: https://tyauto.name.vn/posts/2026-09-17-personal-feed-event-driven.html
Hostinger VPS — 9router proxy
Proxy định tuyến API AI: giảm chi phí token và tự phân phối yêu cầu qua hơn 40 nhà cung cấp LLM. Triển khai một cú nhấp, sao lưu tự động hằng tuần. giảm tới 69%
Hostinger VPS — n8n tự lưu trữ
Chạy n8n tự lưu trữ: workflow không giới hạn, số lệnh chạy đồng thời không giới hạn, dùng được node cộng đồng. Hoàn tiền trong 30 ngày. giảm tới 69%