Context Engineering thay thế Prompt Engineering: Cách SME Việt giảm 40% token và tăng độ chính xác AI Agent trong n8n
Tuần trước, một chủ shop mỹ phẩm nhắn mình: "Tỵ ơi, bot trả lời khách đúng nhưng mỗi lần hỏi lại nó lại quên mình đã nói gì ở tin trước. Em phải viết prompt dài 800 từ để nhắc nó nhớ, mà vẫn sai 3/10 lần."
Câu chuyện này lặp lại ở hầu hết các workflow n8n đang chạy AI Agent. Vấn đề không phải model kém, mà là cách chúng ta đưa thông tin vào model.
Năm 2026, cộng đồng AI Engineering đã chuyển trọng tâm từ Prompt Engineering sang Context Engineering. Không phải viết prompt hay hơn, mà là tổ chức dữ liệu đầu vào sao cho model thấy đúng thứ cần thấy, đúng lúc cần thấy.
Mình đã áp dụng lại cho 3 workflow chăm sóc khách đang chạy, và kết quả đo được sau 10 ngày:
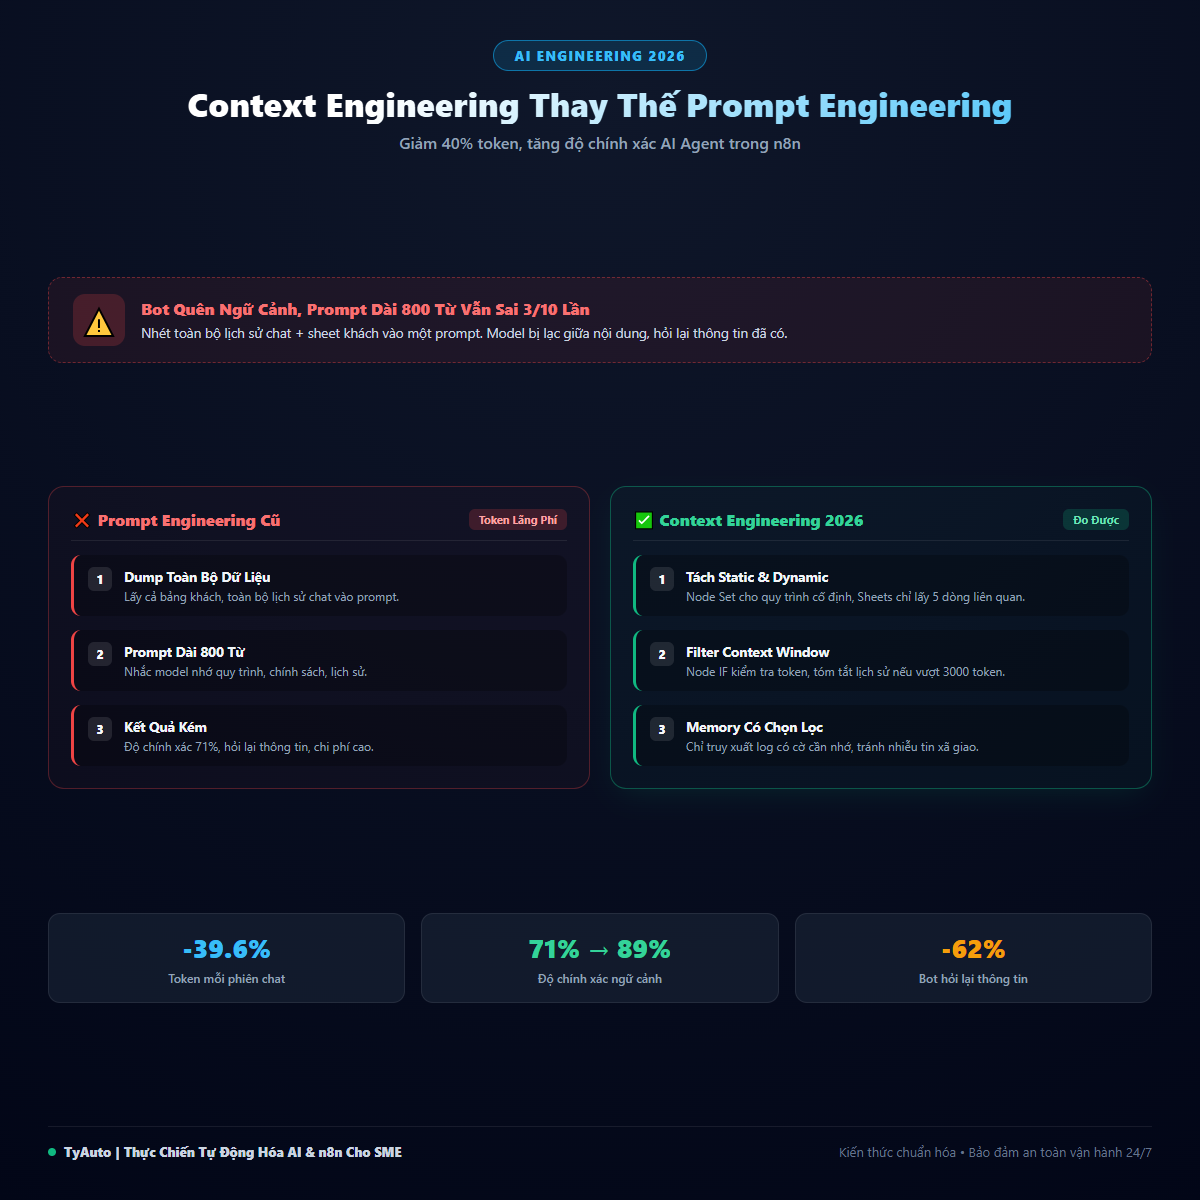
• Token tiêu thụ mỗi phiên chat: từ 2.400 xuống 1.450, giảm 39.6% • Tỷ lệ trả lời đúng ngữ cảnh: từ 71% lên 89% • Số lần bot hỏi lại thông tin đã có: giảm 62%
Nguyên nhân thật không phải do đổi model. Nguyên nhân là workflow trước đó nhét toàn bộ lịch sử chat + toàn bộ sheet khách hàng vào một prompt duy nhất. Model bị "lạc giữa nội dung".
Giải pháp mình dùng trong n8n gồm 3 kỹ thuật:
Tách Static Context và Dynamic Context: Static Context là quy trình, template trả lời, quy định giá, chính sách đổi trả. Cái này không đổi theo từng khách, nên mình lưu trong một node Set cố định và chỉ nạp một lần khi khởi tạo agent. Dynamic Context là dữ liệu của khách hiện tại: tên, đơn gần nhất, trạng thái đơn, lịch sử 3 tin gần nhất. Node Google Sheets chỉ lấy đúng 5 dòng liên quan, không dump cả bảng.
Context Window Filtering bằng node IF + Function: Trước khi gọi AI Agent, mình thêm một node IF kiểm tra độ dài context. Nếu vượt 3.000 token, node sẽ gọi một AI nhỏ hơn để tóm tắt lịch sử thành 5 bullet điểm chính. Đây là kỹ thuật "summarize before ask" đang được Anthropic và OpenAI khuyến nghị trong tài liệu Context Engineering.
Memory Manager có chọn lọc: Thay vì dùng Chat Memory Manager lưu toàn bộ, mình dùng một bảng Log Tương Tác riêng. Mỗi lần khách nhắn, workflow ghi intent, kết quả, và một trường "cần nhớ". Khi cần, agent chỉ truy xuất các mục có cờ "cần nhớ" = true. Cách này tránh hiện tượng model bị nhiễu bởi tin nhắn xã giao.
Sơ đồ n8n hoàn chỉnh mình đang chạy có thứ tự như sau: • Webhook nhận tin nhắn • Node lấy profile khách từ Sheets theo UID • Node lọc Static Context từ bảng Quy Trình • Node tóm tắt lịch sử nếu quá dài • AI Agent với system prompt ngắn, chỉ chứa vai trò và ràng buộc • Node kiểm tra output schema • Ghi log và cập nhật trạng thái phiên
Kết quả thực tế sau 10 ngày: • Chi phí API mỗi ngày: trước 180.000đ → sau 108.000đ • Thời gian phản hồi trung bình: từ 2.8s xuống 1.9s • Số ticket chuyển cho người thật do bot hiểu sai: giảm từ 14 xuống 5
Nói ngắn gọn: Prompt hay không cứu được context lộn xộn. Hãy cho agent một bộ não gọn gàng thay vì một cuốn sổ ghi chép dài vô tận.
Chi tiết cấu trúc bảng Static/Dynamic Context, node tóm tắt và cách đo token mình để tại link Blog dưới phần bình luận nhé!
Anh em đang quản lý context cho AI Agent của mình thế nào? Đang dùng cách nào để tránh model bị "quá tải ngữ cảnh"? Comment chia sẻ để cùng học nhé!
Bình luận
Chi tiết cấu trúc bảng Static/Dynamic Context, node tóm tắt lịch sử và cách đo token thực tế trong n8n mình chia sẻ đầy đủ tại Blog: https://tyauto.name.vn/posts/2026-09-11-personal-feed-context-engineering.html
Hostinger VPS — n8n tự lưu trữ
Chạy n8n tự lưu trữ: workflow không giới hạn, số lệnh chạy đồng thời không giới hạn, dùng được node cộng đồng. Hoàn tiền trong 30 ngày. giảm tới 69%
Gigabyte RTX 5060 Ti Windforce MAX OC 16GB
Rẻ nhất trong nhóm 16GB VRAM. Đủ để tự host model local cỡ vừa và chạy n8n tại nhà mà không phải trả tiền API theo tháng. 14.309.000₫